2026-09-15 晚上,我对着手机讲了一百来秒,说的是中文怎么去 AI 味。第二天打开听记,它把整件事听成了「AI 喂」:标题写成了去口语化工程,正文一路写成数据投喂。这段听记是我自己的私人记录,没有公开,凡是从它来的引文和数字,外部都核不了。
同一段里还有另一种错。我说的是「这明显不是模型训练嘛,就是去模拟」,摘要把它改写成了「并非单纯的模型训练,而是涉及模拟与加工的过程」。意思没丢,人没了。
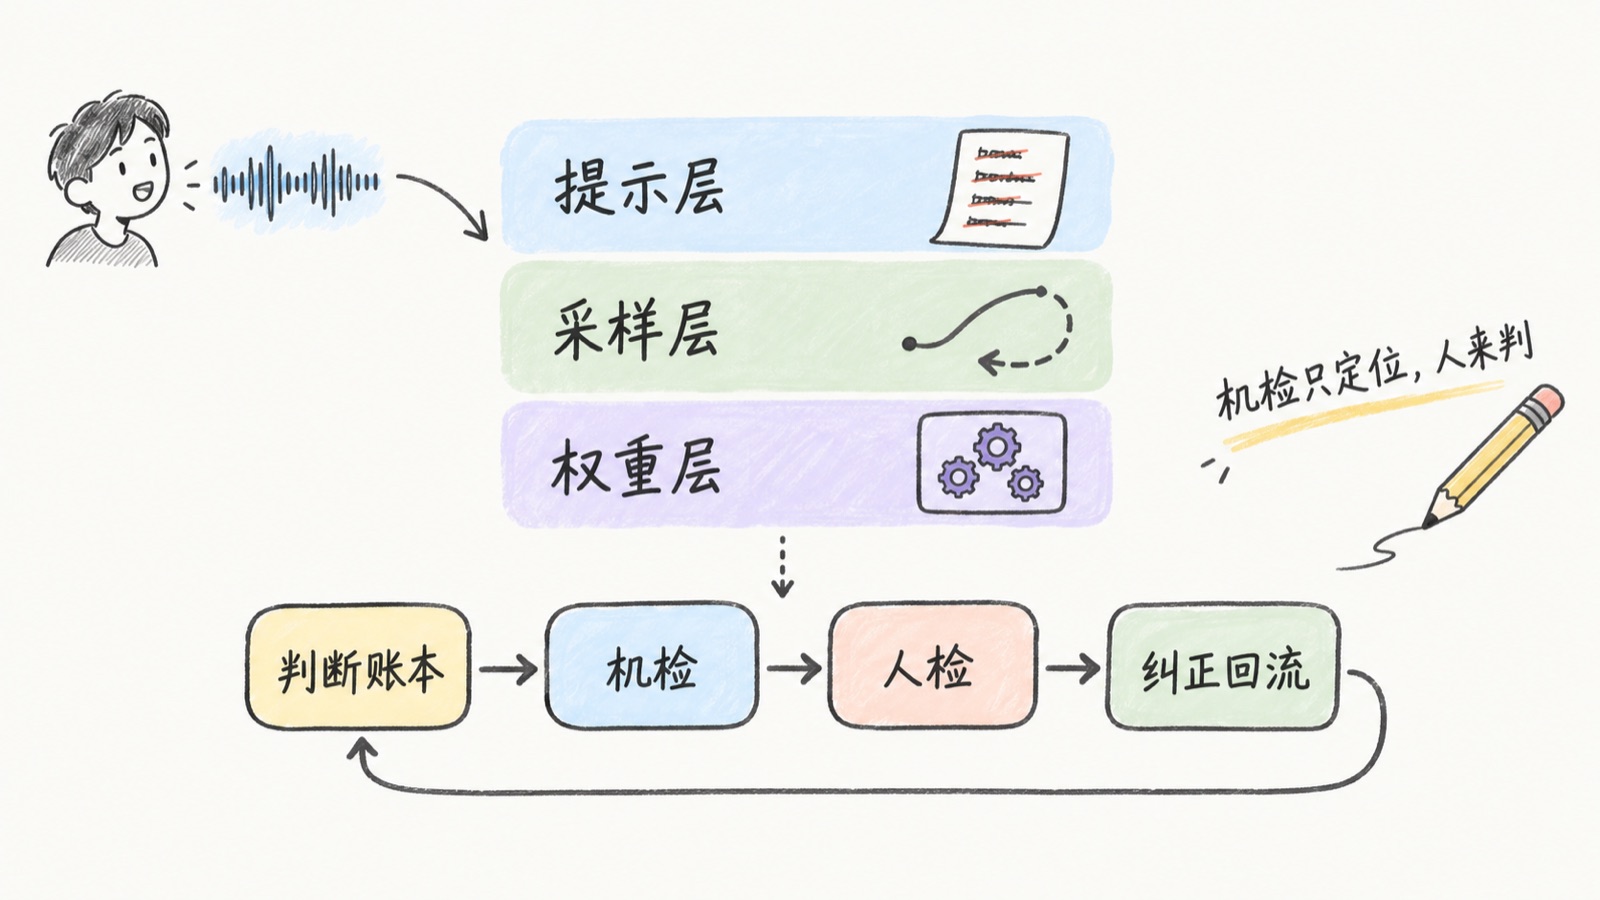
主题被听错,属于事实层面的错;口气被改造,属于口吻层面的错。这两类错得分开治,因为治它们的不是同一件工具。 通用套话交给模型,剩下的靠应用层一条四步流水线:先把你说过的话抄成清单管事实,再让脚本扫出可疑的位置,然后自己逐条判留还是改,最后把人挑过的毛病记回规则里。读完这篇,你会有这四步的做法、能直接跑的命令,和一套检查「这一稿能不能发」的标准。
为什么只能搭在应用层
| 层 | 代表做法 | 谁能做 |
|---|---|---|
| 提示层 | 给模型一张禁用清单 | 谁都能做 |
| 采样层 | 解码时拦住禁用词和短语 | 能碰 logits 的人 |
| 权重层 | 把「别这么写」训进模型 | 训模型的人 |
| 验收层 | 拿语料量出来,卡住误报 | 谁都能做,但很少人做 |
中间两层对你关着门。antislop-sampler 在解码时回溯重采,论文测出禁用表一千条时吞吐掉 69%、八千条掉 96%,README 还直说 “that rules out most commercial APIs since few let you specify logit biases”。权重层是厂商的活:GPT-5 的 system card 写 “System prompts, while easy to modify, have a more limited impact on model outputs relative to changes in post-training.”,Kimi K2 把不许拿夸用户或夸问题开头这条写进了 RL 评分规则,StyleVector 把个人风格提成激活空间里的一个向量。这些都落在模型内部,碰不到你手上这份稿子。
剩给你的就是提示层和验收层:前者让模型少犯,后者证明你没改坏。下面那四步就架在这两层上。
开始之前
准备四样东西:
- 一份原始材料,口述逐字稿、选题记录,或任何你亲口说过的版本。
- 一个 Python 3.11 环境,脚本只用标准库,macOS 与 Linux 都能跑。
- 一份你信得过的人类语料,十来篇自己写的旧文就够,用来测规则会不会误伤。
- 一个自己写的检查脚本。下面这版存下来就能跑,够复现本文的例子。
这条流水线怎么搭
-
先把你自己说过的话抄下来。 动笔前把原始材料里的判断、数字、原话逐条抄进一个临时文件,每条注明出处;稿子改完,拿这份清单一条条核对,方向、强度、限定词有没有变。这一步管的是事实,别人踩过坑才补上的。有人发现 humanizer 自己的示例在教模型编出一场不存在的采访,于是它加了 “Never invent facts” 并把示例全部重切;反向那次(#212)是 “The single most important new build” 被改成 “The important new build”,而在一份选型建议里,那个排序就是结论。
-
让脚本扫一遍,它只报位置,不动你的字。 我这份规则表 18 条,分成必改和待定两档(输出里记作 P0 和 P1)。规则有三个来源。公开清单负责先把量堆起来(起点是 Wikipedia 的 Signs of AI writing,但它跟着模型版本换,Claude 系统提示里的禁用词两个月就从 “actually” 换成了 “straightforward”))。拿真语料测过,才知道该删哪几条。作者本人挑的毛病负责往上加,而且优先级最高。
删规则这一步最容易被跳过。lieflat 拿 629 篇、283 万字做人机对照,流传的 26 项特征只有 11 项真有区分度,还有几项方向是反的:人类用比喻是生成文本的 2.4 倍,正文设问 17 倍。所以规则表旁边得挂一张同样有效力的「不算 AI 腔」清单:句长参差、被动句、正文里的「首先……其次」、设问、比喻,命中也不改。中文这边的底子来自 CCL 2023 上朱君辉等人那篇:ChatGPT 的中文更书面,单音节词占比 0.379 对人写的 0.483,语气词密度 0.003 对 0.016。它测的是 GPT-3.5,人类那侧是网络问答,所以只能当方向,不能当阈值。
我自己那份一百五十行,只用标准库,干的事就一件:把能指出来的地方标上行号。下面这版更短,留了本文例子用到的三条规则,存成 voice_check.py 就能跑:
import re, sys
RULES = [    ("T01", "P0", "翻案腔", r"并非[^。!?\n]{0,40}而是|不是[^。!?,,\n]{1,30}[,,]\s*是[^的否]", "line"),    ("T02", "P0", "破折号", r"——", "line"),    ("T16", "P1", "加粗过多", None, "bold"),]
def strip(text):    """把不该按口吻判的位置置空:frontmatter、代码块、引用、表格、行内代码、链接地址。"""    lines, out, fm, fence = text.splitlines(), [], text.startswith("---"), False    for i, line in enumerate(lines, 1):        if fm:            fm = not (i > 1 and line.strip() == "---")            out.append((i, "")); continue        if line.lstrip().startswith("```"):            fence = not fence; out.append((i, "")); continue        if fence or line.lstrip().startswith((">", "|")):            out.append((i, "")); continue        clean = re.sub(r"`[^`]*`", "", line)        out.append((i, re.sub(r"\]\([^)]*\)", "]", clean)))    return out
def paragraphs(lines):    paras, cur = [], []    for ln, t in lines:        if t.strip() and not t.lstrip().startswith("#"):            cur.append((ln, t))        elif cur:            paras.append(cur); cur = []    return paras + ([cur] if cur else [])
def check(path):    lines = strip(open(path, encoding="utf-8").read())    hits = []    for rid, level, name, pattern, scope in RULES:        if scope == "line":            for ln, t in lines:                for m in re.finditer(pattern, t):                    hits.append((ln, level, rid, name, t[max(0, m.start() - 12):m.end() + 12].strip()))        else:            for para in paragraphs(lines):                n = sum(len(re.findall(r"\*\*[^*\n]+\*\*", t)) for _, t in para)                if n >= 2:                    hits.append((para[0][0], level, rid, name, f"本段加粗 {n} 处"))    hits.sort()    p0 = sum(1 for h in hits if h[1] == "P0")    print(f"# {path}:P0 {p0} 处,P1 {len(hits) - p0} 处")    for ln, level, rid, name, snippet in hits:        print(f"  L{ln:<4} {level} {rid} {name}:{snippet}")
for f in sys.argv[1:]:    check(f)
两个细节比正则本身更影响可用性。每条规则要声明作用范围,逐行扫还是只看第一段、只看末段、按段统计加粗,写错就会到处误报;跑之前还得把 Markdown 剥掉一层,代码块、引用、表格、链接地址都不该按口吻判,不然参考条目自带的破折号会让每篇都报一堆误报。
输出只有行号加规则编号,一个字都不会被改,下一步就能看到真实的一次。
不让它自己改,是故意的。改写要看上下文,正则只认字面。写这篇时它每一轮都会报几处必改,每一处我都留了:开场那句原话和摘要改写的对照、引文里的英文破折号、我复述旧文命中的「全链路」那个词。真让它自动改,先被改掉的是我的证据。
- 自己逐条看,最多改两轮。 脚本报的每一处都要看,但看完可以判「留着」。改写次数得设上限,avoid-ai-writing 的
--iterate就是硬封顶两轮,理由是再改下去只会开始改内容。
拿开头那份听记摘要试了一次。整篇 1144 字,我从里面截了两节存成 demo-before.md,383 字(wc -m,含标点、Markdown 标记和换行)。下面就是送进脚本的全文:
本次交流围绕“中文内容如何有效喂给AI”这一核心议题展开,探讨了数字员工数据投喂的工程化现状、模型优化趋势及开源Skill的逆向研究方法,并提议将该探索过程整理为技术博客。
## 现状分析与不确定性
- **当前实践局限**  - 目前团队虽进行了大量训练以实现AI投喂,但尚未形成**体系化的工程**方案。- **未来趋势研判**  - 对于该工作是否会在短期内被模型自身优化所替代,目前持**不确定**态度,认为需要进一步探索。
## 研究方法与行动建议
- **开源Skill逆向研究**  - 通过分析开源 **Skill** 的制作说明、GitHub 上的 **Issue** 和 **PR** 迭代记录,推导其构建逻辑和加工过程。  - 重点研究仿写类 Skill 的具体实现方式,明确其并非单纯的模型训练,而是涉及模拟与加工的过程。
脚本扫这份文件的结果是必改一处、待定两处:
$ python3 voice_check.py demo-before.md# demo-before.md:P0 1 处,P1 2 处 L5 P1 T16 加粗过多:本段加粗 4 处 L12 P1 T16 加粗过多:本段加粗 4 处 L14 P0 T01 翻案腔:的具体实现方式,明确其并非单纯的模型训练,而是涉及模拟与加工的过程。整篇 1144 字跑下来是 P0 一处、P1 五处:四处加粗过密加一处弱动词加名词,摘录这两节占了其中两处加粗。这一组数字来自那份未公开的摘要,只有我本地能复核;下面两段摘录的字数和命中,你可以照着复跑。
我照着账本把这两节重写成 demo-after.md,180 字:
这段口述问的是一件事:中文怎么去 AI 味。我们做过不少处理,但没成体系。这件事会不会很快被模型自己解决掉,我不确定,所以想查两件事:模型公司在不在做;不做是不是因为要吐大量 token。
查法是看几个开源 skill 的 GitHub:它们的 Issue 和 PR 一路改过来,能看出这东西是怎么攒出来的,尤其是仿写那一类。这明显不是模型训练,是去模拟。
再扫一遍:
$ python3 voice_check.py demo-after.md# demo-after.md:P0 1 处,P1 0 处 L3 P0 T01 翻案腔:尤其是仿写那一类。这明显不是模型训练,是去模拟。待定项清零,必改还剩一处,命中的是末尾那句「这明显不是模型训练,是去模拟」。这一处我留了,它是我的原话(改写时顺掉了口语的「嘛」和「就」),而且它纠正的误解真实存在,不是虚立一个误解再推翻。脚本只负责指出位置,判断权在人手里。
更要紧的一处,脚本从头到尾没看见:摘要把我讲的「去 AI 味」写成了「数据投喂」,一路错到标题。正则不认识事实,抓到它的是第一步那份清单。
- 把人挑的毛病记回规则里。 作者说「这里不像人」的每一次,都把改前、改后、为什么记进 taste 文件,下一篇起草时它压过通用规则表。这一步做不做,决定这套东西是一张死清单,还是一条会长的流水线。
怎么检查这一稿能不能发
四条都过了才算。
先看有没有改坏:拿那份抄下来的清单逐条核对成稿,每条判断、数字、原话都还在,强度和限定词没变。少一条就补回去,这条比任何口吻问题都优先。
再看 AI 腔清没清干净:重跑一遍脚本,必改项要么归零,要么剩下的每一处你都说得出是按哪一条留的。
还要看像不像你,这条机器判不了。把改前、改后和自己一篇旧文放在一起读,先写下这次要的三条口吻要求,再逐条判改后那版做到没有。做不到就退回第三步,别靠加规则解决。
最后看规则有没有误伤:同一份规则跑一遍你那十来篇旧文,按每千字命中数算。在那些文章上报出来的每一处,按定义都是误报;多到影响判断,就回去删规则,别回头改文章。avoid-ai-writing 把这件事做成了 CI 里的分数预算,超了就红。
别人走到哪一步了
同样这四步,开源仓库里有人只做了第一步,有人四步走完还往下多走了一段。
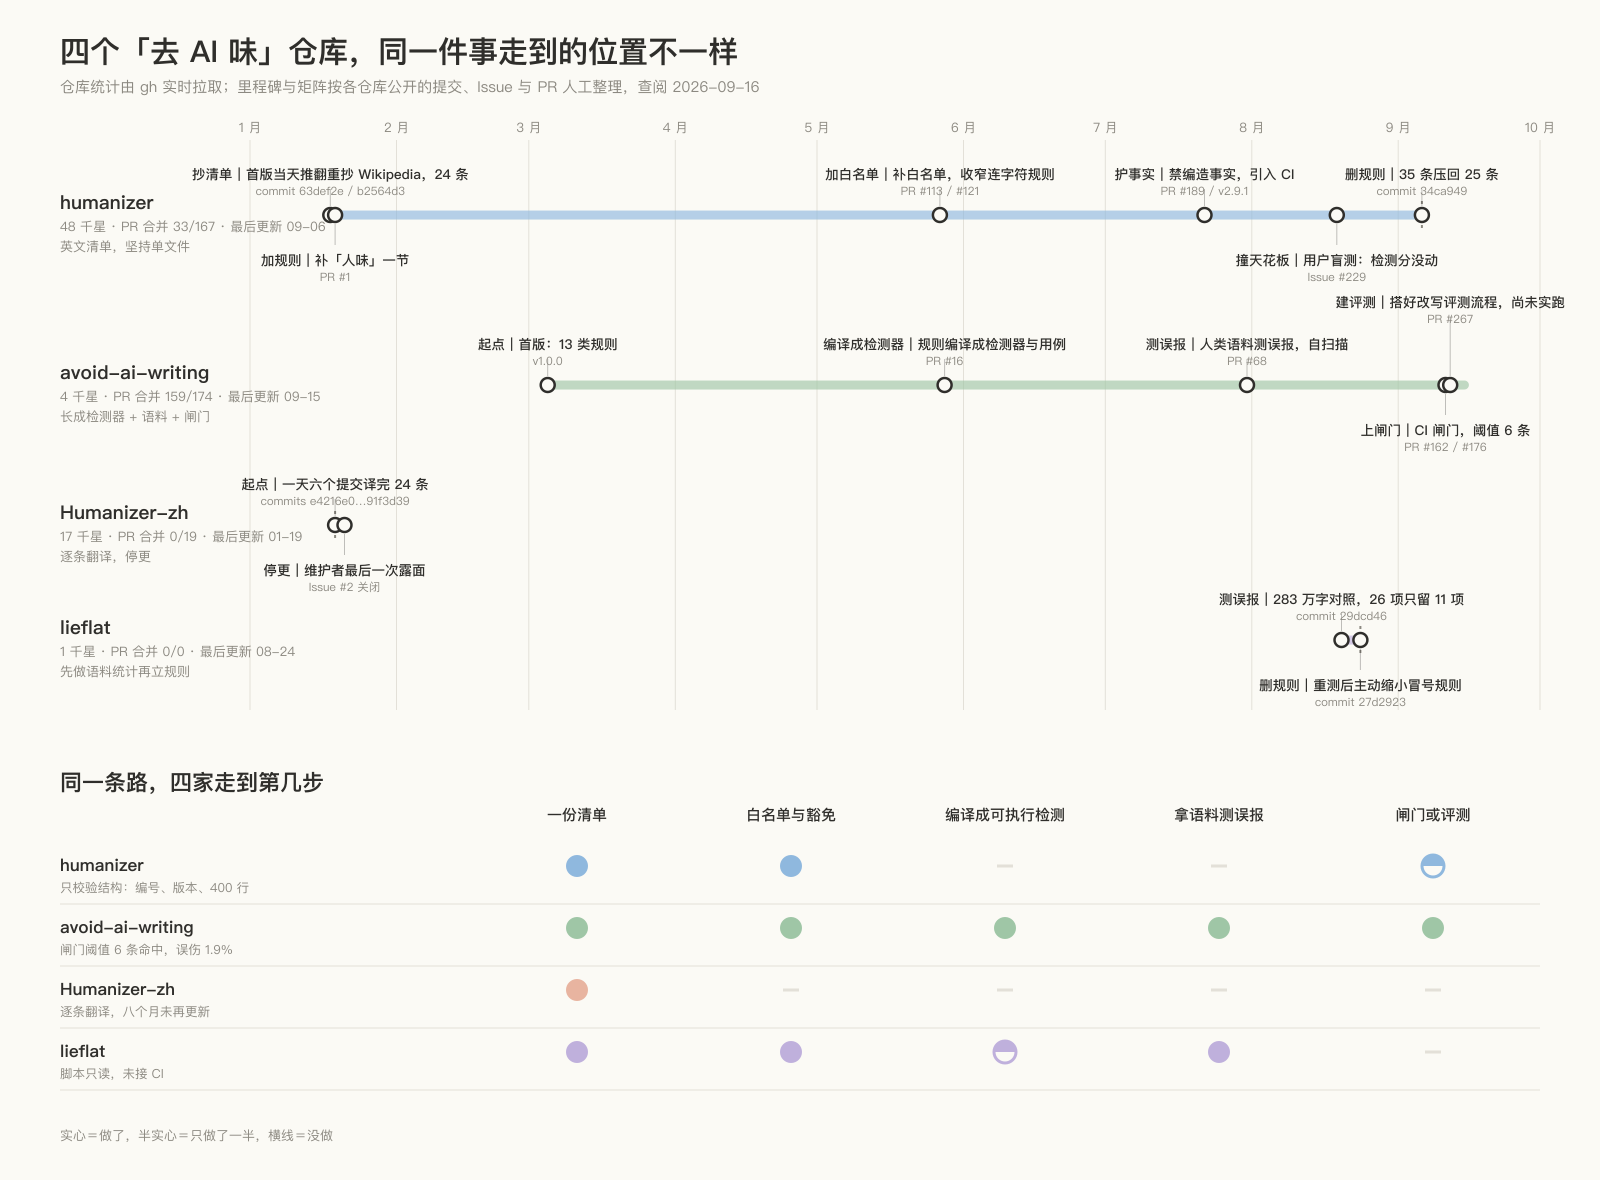
图里每个点都对应一条可打开的记录。星数、PR 合并数、首末更新时间是用 gh 从 GitHub 实时拉的,里程碑和那张矩阵是我按公开记录人工整理的。
规则入口卡得越死,清单越不容易烂。 humanizer 收了 167 个 PR 只合 33 个,判据写死在 AGENTS.md 里:一个新痕迹,只有现有规则覆盖不了,才配单独成条;被接受的典型形状是一个 PR 只加一个词。规则多了还会自己打架:自检要求不许丢主张,可有七条规则本身要求删主张(#236),这种冲突校验脚本查不出来。
敢测自己的那家,先打了自己的脸。 avoid-ai-writing 把闸门定在每文件 6 条命中,因为 376 篇纯人写文档在这个阈值误伤 1.9%,卡零命中要误伤 31.4%;它还量出 112 条词表的 lift 只有 0.9(在人写文本上命中得还更多一点),综合分数接上机器语料后 ROC-AUC 是 0.501,CHANGELOG 原话是 “0.5 is a coin flip.”。
词表不跨语言,结构规则跨语言。 humanizer 的中文版是逐条翻译的,讲英文标题首字母大写那条搬进中文后,示例的改写前后一字不差。一位做葡语适配的人把规律说清楚了:词表完全不能迁移,结构规则几乎原样成立。
至于这条路的上限,humanizer 的 #229 里有位用户做了盲测:改写稿在质量上 16 比 0 胜出,检测分几乎没动,而痕迹计数是词汇类 70 降到 0、节奏类 60 涨到 101。减法改写让文章更均匀地好看,均匀本身又是一种痕迹。
什么时候不要这么做
聊天里问一句答一句不值得走流水线,多一轮改写就多一轮 token 和等待。
没有你自己的样稿和纠正时,这条流水线只能让文章不太像 AI,不会让它像你。那种情况下先去攒素材,别先调清单。EMNLP 2025 Findings 上那份大规模实验测过这一截:给五篇样稿做 few-shot 仿写,博客体的作者归属只有 38.47% 到 44.34%,论坛更低,而同一套评测跑人写的原文是 79.8% 到 95.5%。
规则表跟着模型版本和语言走。换了模型、换了文体、换了语种,先拿一份纯人写的语料重测误报,再决定加规则还是删规则。哪天你的默认输出在自己的对照语料上已经测不出差异,第二步就可以拆了。
参考
- blader/humanizer(查阅 2026-09-16)— 清单类 skill 的代表,四万八千星,167 个 PR 合了 33 个。本文用到的记录:首个重写提交(抄 Wikipedia)、PR #1(补人味)、#72 与 #206(用户报新痕迹)、PR #113(不要标记什么)、PR #121(收窄连字符规则)、PR #189(Never invent facts)、#212(改写删掉排序主张)、PR #236(自检与规则对账)、v3.0.0 提交(35 条压回 25 条)、AGENTS.md(准入与发版纪律)、validate-package.py(400 行上限等五项校验)、#229(用户盲测:质量 16/16,检测 100%→98.6%→97.8%,词汇类痕迹 70→0、节奏类 60→101)。支撑「从 Issue 和 PR 看它们怎么长出来」整节。
- conorbronsdon/avoid-ai-writing(查阅 2026-09-16)— corpus/README 说明纯人类语料上的每一次命中都是误报;README 写明
--iterate上限为 2;CHANGELOG 记着 1.0.0 的 13 类规则、闸门阈值 6 条对应 376 篇人写文档 1.9% 误伤(零命中为 31.4%)、接 RAID 与 HC3 后综合分数 ROC-AUC 0.501 与 “0.5 is a coin flip.”、以及把上游「5 到 20 倍」标注为 inherited rather than measured;corpus/README 里tier1词表 lift 0.9、em-dashlift 0.2。支撑验收层、封顶两轮与「检测分数不能当验收」。 - larashero3-dotcom/lieflat-less-ai-tone(查阅 2026-09-16)— 629 篇、283 万字人机对照,26 项特征只有 11 项有区分度;比喻 2.4 倍、设问 17 倍;破折号跨模型差四十倍。RESEARCH.md 记了六次测量失误与那条操作要求:「改规则前先抽样看 20 条命中,再看频率」,结构类指标的分母必须是同类元素总数。支撑白名单、抽样规程与「AI 味不是一种」。
- op7418/Humanizer-zh(查阅 2026-09-16)— humanizer 的中文版,逐条翻译,六个提交集中在同一天后停更,外部 PR 零合并;SKILL.md 第 16 条「标题中的标题大写」示例改写前后一字不差;#11 报中文标点被改成英文标点;#38 给出人写中文三字格四字格排比是机器翻译 2 到 10 倍的实测(作者注明英文侧语料全为人写)。支撑「词表不跨语言」。
- avoid-ai-writing issue #142(查阅 2026-09-16)— 葡语适配者写道 “The lexical tables don’t transfer at all.”,以及 “The structural rules transfer almost unchanged.”。支撑词表与结构规则的迁移差别。
- OpenAI 开发者文档:latest model 指南(查阅 2026-09-16)— “Avoid using slop words or phrases like “Bottom Line:” in conclusions, “delve,” “foster,” “leverage,”“。支撑模型公司也在发清单。
- Claude Opus 4.8 系统提示 与 Claude Opus 5 系统提示(查阅 2026-09-16)— 禁用词从 “actually” 换成 “straightforward”。支撑清单会过时。
- OpenAI GPT-5 System Card(查阅 2026-09-16)— 系统提示影响有限,谄媚靠后训练压。支撑权重层。
- Kimi K2 技术报告(查阅 2026-09-16)— 附录 F.2:“Initial Praise: Responses must not begin with compliments directed at the user or the question”。支撑规则可以直接进 RL。
- Antislop(arXiv 2510.15061)(查阅 2026-09-16)— “frequent backtracking decreases performance by 69%-96%, depending on banlist size”;摘要 “FTPO achieves 90% slop reduction while maintaining or improving performance in cross-domain evals”。支撑采样层的代价与权重层的划算。
- sam-paech/antislop-sampler(查阅 2026-09-16)— 多数商用 API 不给 logit bias;正则禁用不支持流式。支撑「采样层对大多数人关着门」。
- C-ReD(arXiv 2604.11796,ACL 2026 Findings)(查阅 2026-09-16)— “128,610 texts, including 12,997 human-written and 115,613 AI-generated samples”。支撑中文侧有尺子。
- 朱君辉等:人工智能生成语言与人类语言对比研究(CCL 2023)(查阅 2026-09-16)— 单音节词占比 0.483 / 0.379,连词密度 0.013 / 0.036,语气词密度 0.016 / 0.003,「和」4.13 / 11.76,「跟」0.18 / 0.03;作者注明底层模型是 GPT-3.5。支撑中文书面语化的画像与它的适用边界。
- Wang et al.:Catch Me If You Can? Not Yet(EMNLP 2025 Findings)(查阅 2026-09-16)— 5-shot 仿写的 Top-5 作者归属:新闻 86.64–93.30、邮件 56.45–62.38、博客 38.47–44.34、论坛 26.30–35.59;人写原文 79.8–95.5。支撑「样稿喂提示不够」。
- StyleVector(ACL 2025)(查阅 2026-09-16)— 风格向量做推理期 steering,“reducing storage requirements by 1700 × over PEFT method”。支撑个性化还有一条模型侧的路。
- Wikipedia: Signs of AI writing(查阅 2026-09-16)— 多个开源清单的共同起点,并单列无效指标。支撑「迹象不是证据」。