一条流程走到第四步卡住了。前面三步跑在云上,哪台机器都行;第四步要去 CRM(客户关系管理系统)里改一条记录,那套系统只认办公网,全公司只有工位上那台电脑进得去。云上那个 Agent 不知道这回事,它做完第三步,沙箱到点回收,第四步没人接。
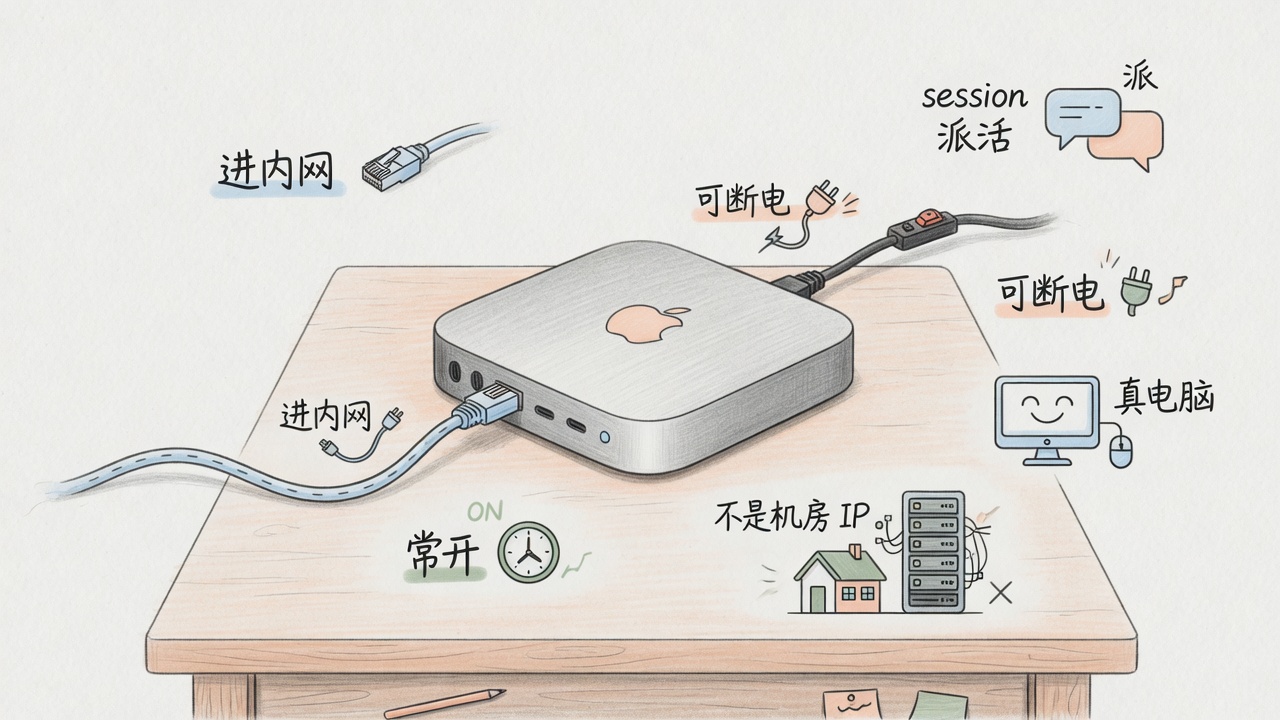
面试的时候我常问一个问题:为什么 AI Agent 需要一个控制力强一些的工作流。最常见的答案是模型不够聪明,所以得有人先把路线画好。这个答案能过,但它解释不了我手上那台机器。同一个 Claude Code,跑在一台不关机的小主机上,没人给它画路线,它自己就把活排完了。
真正的分水岭在那台机器会不会被收走。而把流程写下来只是代价,换回来的东西比执行本身大:判断有地方落,组织第一次看得见它。我认为一个 AI 原生的组织,必须把自己协作和协同的工作流交给 Agent 驱动。
开头那段是场景,不是某一次实测记录。这种卡法我见过很多次,但没留下可核的运行日志。下面能核的是公开出处那几条。
一条流程跑在好几台不一样的机器上
长流程的节点是不一样的东西。有些跑在云上可复用的机器资源上,随便调度;有些只能落在特定那台本地电脑上,内网操作、CRM 里的处理,换台机器就做不了。
把人放进去之后更明显。有些节点必须人来点头、人来补一格。这时候流程由 AI 转动,人在里面协作,最后是人和数字员工一起把它做完。
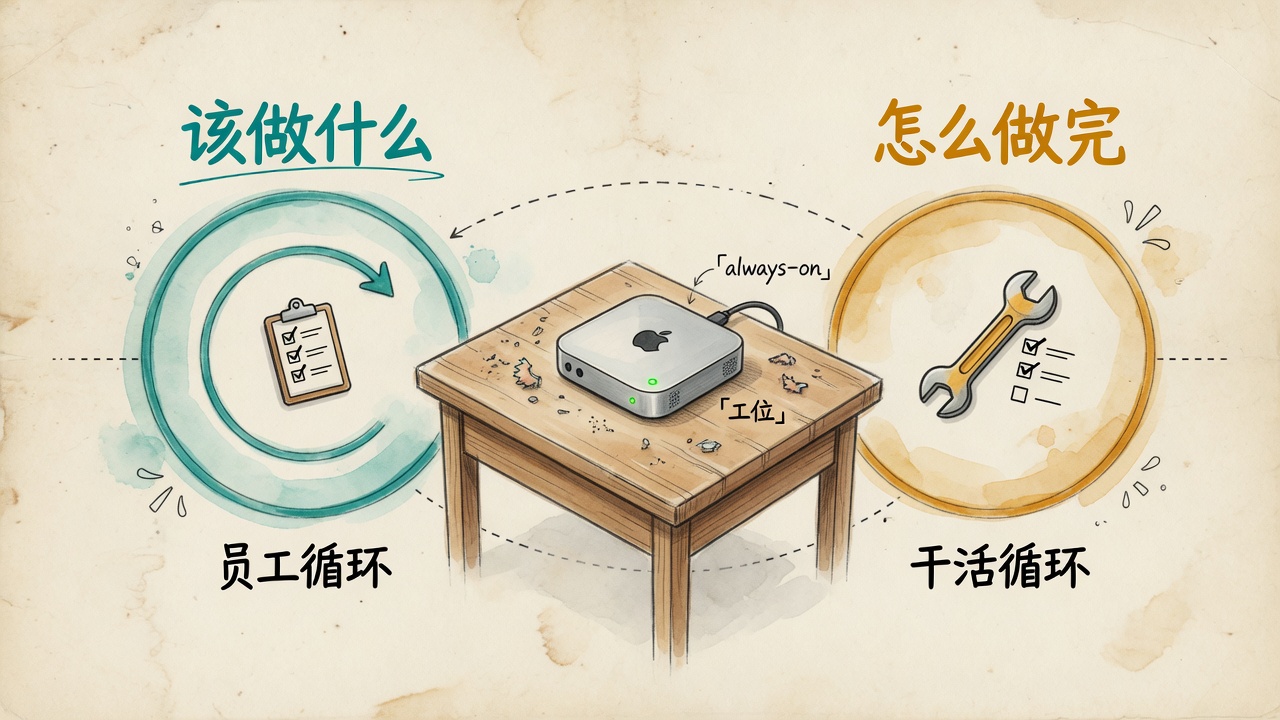
跨机器、跨人、跨天的执行,必须有个东西在 Agent 之外记着进度。这一段上一篇《数字员工要把「该做什么」和「怎么做完」拆开》已经讲完了,这篇不重讲,只接着问它的前一个问题:为什么这条流程得被写下来。
那台不关机的机器确实不需要流程
先把反方立住,因为它有一半是对的。
给 Claude Code 或者 Codex 一台不销毁的机器,它依次执行,靠强推理和上下文管理,自己就能当场编排出一套动态工作流;或者干脆把核心步骤记在文件里,走一步划掉一行。再给它一套沟通工具,它还能写个脚本在那边监听。
这不是理论。常开的那台小主机上,跟模型的那次会话(session)一直在,进程一直占着,机器不会被收走,所以「流程」这件事可以完全活在模型的上下文里,不需要任何人写下来。
分水岭是机器会不会被收走
换到云上就不成立了。沙箱出于成本要销毁,模型也不可能一直用强模型。任务还得又好又快地完成。
这三个条件同时成立的时候,显式工作流才是必需的。模型还是那个模型,变穷的是执行环境,穷到状态没地方存。
Anthropic 那篇 Building effective agents 给的分法很接近:他们把 workflow 定义成大语言模型(LLM)与工具被预先写好的代码路径编排,agent 定义成 LLM 自己决定流程和工具怎么用;任务定义清楚时用 workflow 换可预测性,agentic 系统则是拿延迟和成本换任务表现。这两句是我从英文转述的,不是原文照录。差别在成本算在哪一侧,他们算在 agent 身上,我这边算在机器上。
写下来的是两样东西
工作流的表现形式可以是一段脚本,也可以是对一张图的简单定义,都行。那是实现,会变。不变的是两样:这个流程应该怎么走,以及怎么算它走完了。
流程的描述加上流程的验证,这两样凑齐才叫写下来。只写了步骤没写验收,换个实现就得重来一遍。
有了这个,Agent 才谈得上恢复。工作流最基本的能力是存住 State:存到当前所处的状态,从这个状态恢复,然后接受新的输入。
也才谈得上算账。每个环节烧了多少 token(模型按它计量和计费的文本单位)、花了多少时间、哪个节点慢,只有被流程组织起来的东西才量得出来。所以在 skills(一个个能被单独调用的能力)和那些写死的简单流程之上,还得有这一层。
它组织的单元也不止于一次会话。它可能跨 session,把会话和人一起组织起来。我说的工作流,「和人协同」是限定词,不是修饰词:不含人的编排,不算。
这些就是公司每天在做的事
讲到这儿才到我真正想说的那一半。
人拿到强大的 AI 工具之后被极大地加强了,个体的效率是上去了。但他为完成这件事付出的那些判断和隐性知识,留在了他自己电脑上的 session log(跟 Agent 一来一回的会话记录)里,没有披露给组织。这是我从同事交流和面试里反复看到的,不是哪份调研的结论。
小到五到十个人的团队,大到一百人以上,都是这个问题。所以出了事你还是得去找人,因为你不知道他额外的那些判断是什么。他对这个系统、这个业务的判断,你拿不到。
人是瓶颈的时候组织就慢。慢在等,也慢在传:来龙去脉、目标是什么、每个环节该怎么做,这些认知在人和人之间传得很慢,带宽很低。
流程交给 Agent 驱动,组织才看得见
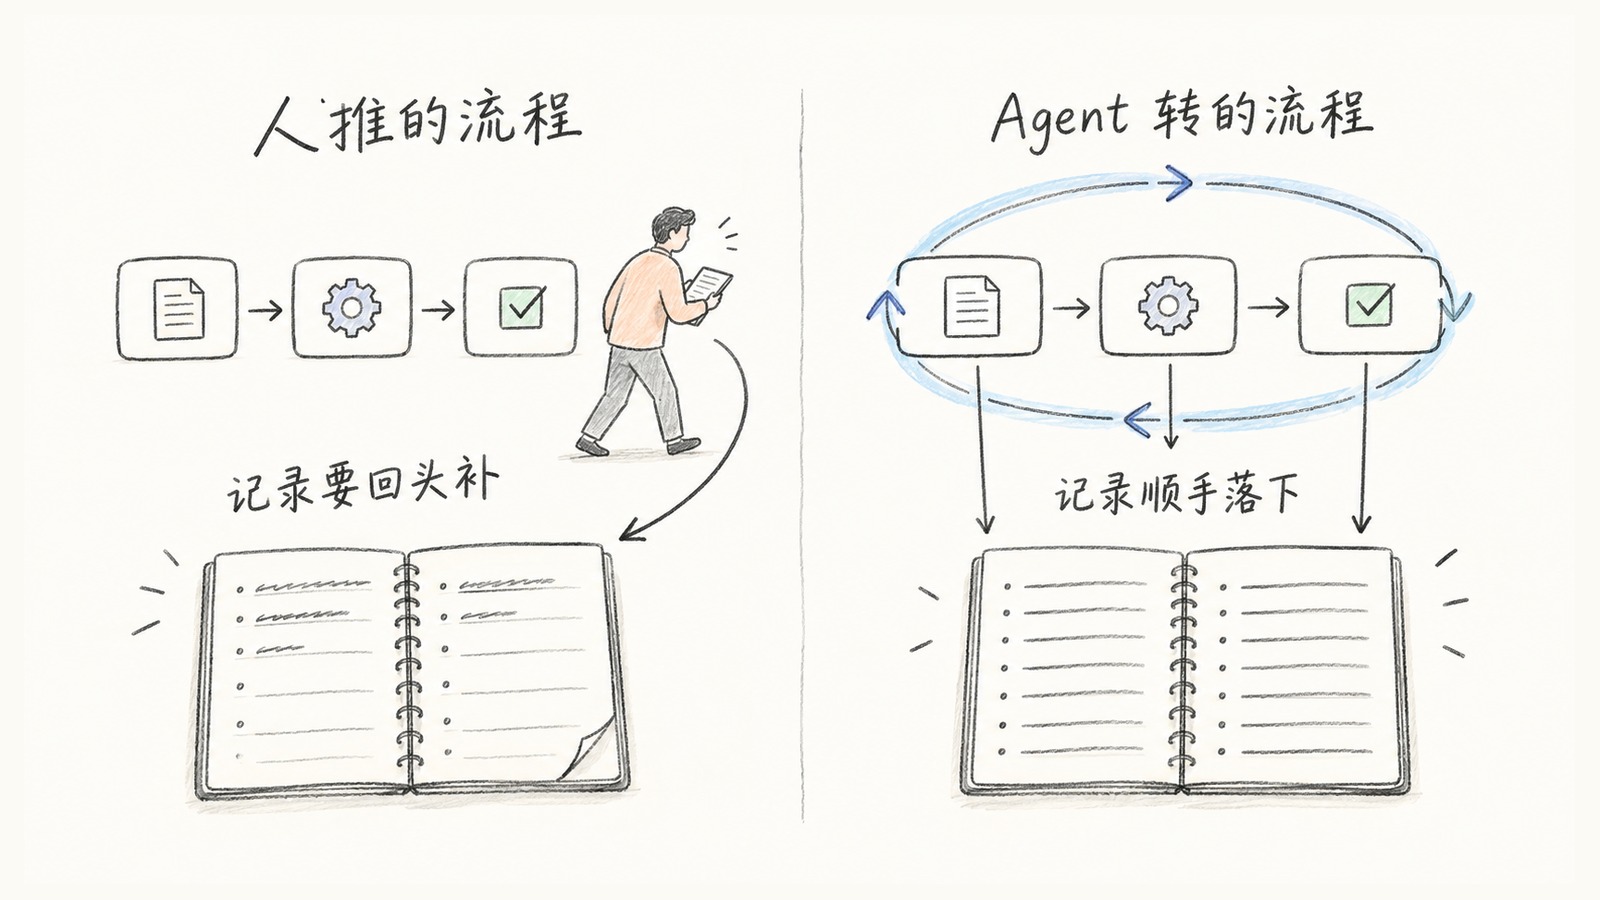
流程由 Agent 转的时候,驱动它的那一端握着这条流程的背景、目标和每一步的执行过程。它就是执行的那一方,这些东西是它干活时顺手落下的,不靠谁额外补一份记录。
它拿不到的也得说清楚:人脑子里没写下来的那部分判断,它照样拿不到。它拿到的是这条流程上发生过什么。
就这一层,也够看出不同的人面对同一类问题,输入产出是什么样、往下推进的效率和结果是什么样。这些东西过去往往很难统计,多半只能靠主观印象。
再往前一步就理想化了:整条工作流都以 log 的形式存在某个 Agent 之下的话,它自己就能发现流程里的优化空间,哪些事可以并行,哪些事必须有先后。这一步我没有跑通过。
外面也有旁证。DORA(Google 那个长期做软件交付效能研究的项目)2025 年的报告,近 5000 人,说法是 AI 不修团队,只放大团队原本的样子,回报来自内部平台的质量和工作流的清晰度,不来自工具本身。工具那一头已经发到每个人手上了,我认为接下来还能动的是流程这一层。
核心是一个范式变了。一个 AI 原生的组织,必须把自己协作和协同的工作流用 AI 来驱动、用 Agent 来驱动。
共享任务系统不也记着吗
这是我这个判断最该被问的一句,比前面那个「强模型不用写流程」狠得多。
公司里早就有共享的任务系统、有负责人的流程文档。它们同样能记上下文、同样能把进度存住、同样能定验收。既然这些都做得到,凭什么非得由 Agent 来转?
这个反方有两个版本,弱的那个好打,强的那个不好打。
弱版本是靠人补记的那类:任务系统里的记录是额外一道工序,干完活人再回去写一条,取决于这个人此刻忙不忙、愿不愿写。忙的时候先跳过,事后补的是结论不是过程,人一走这条流程就断在他那里。这一版我认为站不住,理由和前面是同一个:人是瓶颈的时候会等,人和人之间传上下文带宽很低。
强版本是执行系统自己留痕的那类:持续集成(CI)的构建日志、审批系统的事件流、工作流引擎的执行轨迹。这些根本不用人动手,是系统在跑的时候自己写的,成本和可靠性上并不输给 Agent。拿「谁来写」去打它,打不动。
真正的差别不在留不留痕,在留的那一段有多长。
CI 的日志只覆盖 CI 里发生的事,审批系统只覆盖审批那几跳,CRM 只覆盖 CRM 里的操作。开头那条流程横跨云上机器、内网那台电脑和一个人,这三段分别落在三套系统里,没有哪一套持有完整的那一条。更麻烦的是它们拼不起来:三段日志没有共同的任务身份,你没法说清 CI 里那次构建和 CRM 里那次改动是同一件事的第三步和第四步。
Agent 驱动的价值就在这儿:驱动的那一端是横跨这些系统的,所以它留的痕天然是整条流程的,不是某一段的。
再往上还有一版,比前面两版都强:统一任务身份、能跨系统、还能挂人工节点的工作流引擎。这类东西在企业里跑了很多年,我上面那套覆盖面的说法打不动它。它本来就是为跨系统和人工节点设计的,任务身份统一,日志也是整条的。
对着这一版,我得把「必须」再收一格。
它只对预先画不出完整流程图的那类工作成立。 流程能事先画全、每个分支都列得出来、每个判断都能写成条件,那传统工作流引擎就够了,多一个 Agent 没有增量。
我关心的是画不全的那一类,也就是企业每天真正在做的那些事:下一步做什么取决于上一步的结果长什么样,中间要有人看一眼再定,而这个人的判断没法事先写成一条规则。图上画不出来的那些分支,引擎只能抛给人;Agent 至少能接着往下推,并且把它当时是怎么判断的留在记录里。
这一段是我的判断,不是实测结论:我没有把同一条流程分别用引擎和 Agent 跑一遍做对照,下面这句往下推的每一步都请按推测读。判断要带着前面那一段,只在分支点叫一次,它手里没有前三步的上下文,只能凭传进去的那点参数决定。所以我要的是整条流程的主语换人,而不是在某几个点上塞一个模型。
人退到哪一步
有人会问,流程都交给 AI 了,人是不是就丢掉了处理公司上下文和隐性知识的能力。
我的看法是第一版流程得由为业务结果负责的那个人创建。他要交付的是业务结果,面向老板,那么流程从哪儿长出来这件事就必须在他手里,把自己的判断写进去。不写下来,那些判断才真的只活在他一个人脑子里。
往后每个人都能让 AI 帮他驱动一条核心流程、优化这条流程。过去他只是流程里的一个节点,以后他慢慢变成和 AI 一起设计流程的人,让 AI 去驱动,关键的时候他来做判断。考核跟着变成对流程的结果负责,不再对单个节点负责。
这对人的要求很高,不是所有人都做得了核心流程的设计和优化。做不了的那部分,理想情况就是交给更专业的人。
流程转起来之后,前置上下文会越来越清晰。清晰到一定程度,有些判断 AI 其实知道过去这个人是怎么做的,它越来越懂。但它替代不了人,因为人是要用来背锅的。组织真正值钱的还是那三样:上下文、对隐性知识的判断、以及组织效率的优化本身。
我还答不上来的那一段
上面这些都是理想化的说法,落地马上会撞上两个问题:谁来建,谁来测。
和人协同的工作流尤其难。人这一侧不可重复,你没法让同一个人用同样的状态再走一遍。方向我有三个但都没想透:得能低成本地把一个组织重复跑很多遍;回放很重要;框架得支持 Actors 和 Director,也就是一组能扮演流程里各个角色的替身,加一个调度它们按剧本走的角色。这三个我都还答不上来,留着下次写。
还有人问过我一个更狠的:人休假了之后,这条流程还在不在跑。那是 Agent 主动性的问题,也留着。
什么时候别这么干
还有一条红线。Kent Beck 和 Gergely Orosz 反驳 McKinsey 的那篇说得很清楚:按指标衡量单个开发者会制造反向激励,人会去优化指标而不是结果,而最好的工作常常是看不见的,比如带人、把问题挡在发生之前、把系统改简单。
我上面说流程转起来能看出不同的人的投入产出,正撞在这上面。我的回应只能回一半:把考核改成对流程结果负责,方向恰恰是 Beck 要的那个,量产出和影响,不量工时和条数。但流程日志一旦被拿回去给单个人计件,这套东西会立刻反噬,而且反噬得比没有日志时更狠,因为它显得客观。这条我没有解法。它是这套做法的红线。
还有一个我打不赢的折中方案,得摆在这儿:引擎编排整条流程,只在画不出来的那几个分支上调一次 Agent。 上面那条「判断要带着前面那一段」的理由,如果引擎肯把整条流程的上下文都喂给分支点上的 Agent,就不成立了。这条我没有证据分高下,先当没打赢记着。
驱动它也不等于自动留全了痕。 身份要一路传下去,外部系统那几跳的回执要收得回来,每一跳都得真写下去。这些是条件,不是搭着送的。
还有三处它不成立。一台不关机的机器加一个强模型,即兴编排够用,不必写流程。一次就做完、没有等待没有副作用的活,不值得写。模型还会继续变强,今天要写下来的步骤明天可能不用写了。但要写下来的从来不只是步骤,还有怎么算做完,后面这半样不随模型变强而消失。
还有,「个体效率上去了」这句我是当体感用的,不是实测结论。METR(一家做 AI 能力评估的机构)做过一个随机对照实验,16 位资深开源开发者、246 个真实任务,用 AI 反而慢了 19%,而他们自估快了 20%。这条我没法反驳,只能说它反过来更支持这篇的做法:体感不可信,得看流程留下的记录。
下次再说「我们团队效率低」的时候,先别急着问该再买哪个工具。挑一件这周被卡住的事,看看它的记录现在在哪儿。如果只在某个人本机的 session log 里,那它下次还得找那个人。
参考
- Building effective agents(查阅 2026-09-18)— workflow 与 agent 的定义分界,以及延迟成本的取舍。
- 2025 DORA State of AI-assisted Software Development(查阅 2026-09-18)— 近 5000 人;AI 不修团队只放大团队,回报来自平台与工作流的清晰度。
- Measuring developer productivity? A response to McKinsey(查阅 2026-09-18)— 衡量单个开发者的反向激励,最好的工作常常不可见。
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity(查阅 2026-09-18)— 资深开源开发者用 AI 慢了 19%,自估快了 20%。
- 数字员工要把「该做什么」和「怎么做完」拆开(查阅 2026-09-18)— 两套循环与 durable workflow 保住那件正在做的事。